
我认真把 DeepSeek Harness、WorkBuddy 和我们自己做的教育数字基座摆在一起想,越想越觉得这三样东西该放在一起看。名字不一样,摆到一起,才看清我们产品该往哪走。
先说结论:基座是 Harness 的实体,WorkBuddy 是它最成熟的一种开箱形态,而 Harness 真正启发我们的,是“让用户自己生长”的那套哲学。
一、三样东西,先摆清楚
基座,是我们做的教育数字基座,含数据中台、统一权限、校核纠错、采集通道。它不上课、不改卷,价值是让上层应用真正作用于课堂。用 Harness 那个比喻,它干的就是马具的活。
WorkBuddy,是开箱即用的 Agent 工作台。厂商备好模型、界面、工具,你进去学怎么用,我们团队日常就用它搭东西,把成熟流程串成工作台。
Harness,是 DeepSeek 没做成完整工作台,而是把“工作台怎么被搭出来”这件事本身交给你,一切皆插件。模型是插件,工具是插件,Skill 是插件,连 Agent 的循环和 UI 都由插件组成。
这三者不是替代关系。基座是底,WorkBuddy 是面上一种现成马车,Harness 是造车哲学。
二、基座天生就是 Harness,只是我们没说透
把教务、学籍、资助三套系统的在校生数对成一份,把分散各校的权限收拢到统一中心,把一次采集通道接到永久库。这活的本质,就是把力量连接起来、组织起来,让它能拉动外部世界。Harness 这个词英文就是马具,既不是马也不是车,是那套连接结构。我们一直干这个,却对外讲成“平台功能清单”。
但 Harness 把“一切皆插件”讲透了,正好戳我们的痛点。我们给省市区交付的基座,模块是焊死的:数据中台一个包、统一权限一个包、应用一个包,彼此耦合。某区要“按校际联盟统计学业质量”,标准版压根没有这个视角;换一个区要“随班就读学生专项台账”,又得重新排期开发。预设的功能,约等于我们预估的最大公约数,未必是客户真实的工作方式。
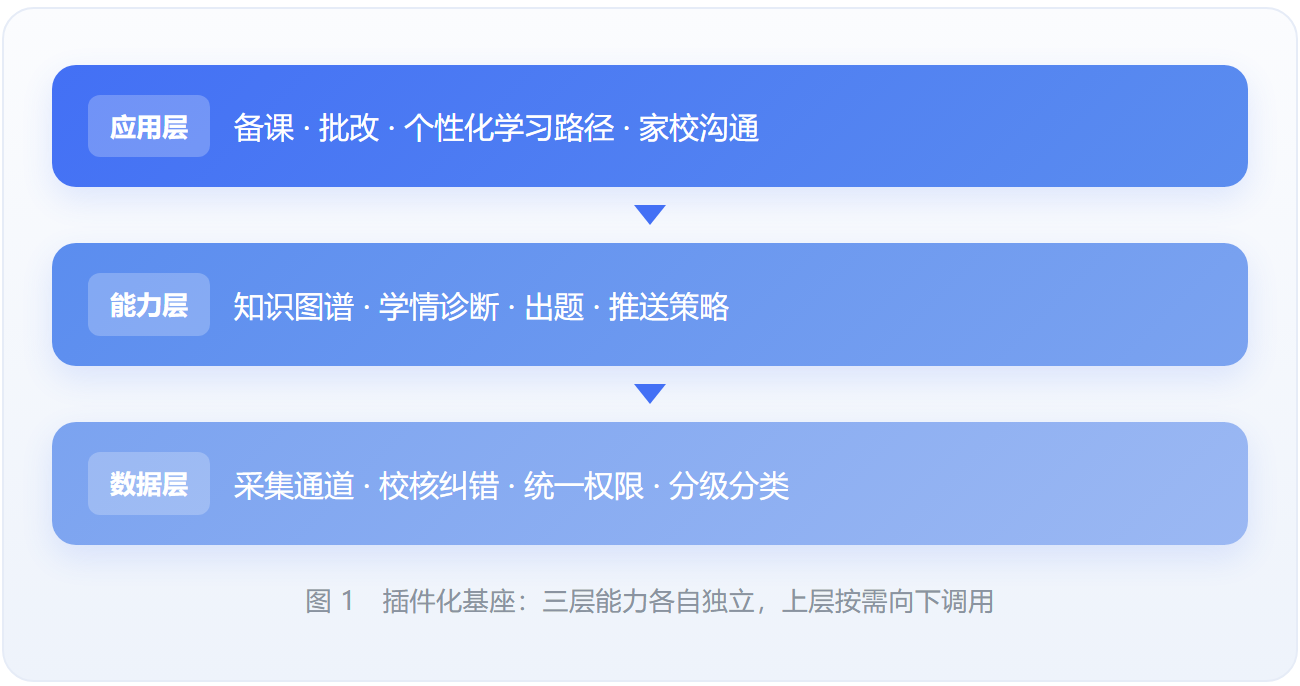
解药是:数据归集、校核纠错、统一权限、AI 出题推送,全做成可独立加载、组合、替换的插件。
三、WorkBuddy 给的参照:开箱即用工作台,今天就该这么交付
把 WorkBuddy 这类开箱即用的 Agent 工作台当作参照,这是当前最稳的交付形态。我们的老师、教研员、区级管理员,大部分人要的就是打开就能用:智能备课、作业批改、学情看板。这部分该做成 WorkBuddy 式开箱应用,别让用户去拼积木。
我自己的体会:用 WorkBuddy 把一个成熟的教学设计流程串成工作台,左边项目目录、右边板块提示,读、判、改、导一气呵成。它的价值不是“瞬间生成一份教案”,是给老师搭好支架。这恰恰是我们基座上层该直接供给的能力。
但开箱形态的边界也要认清:预设功能约等于厂商的最大公约数,覆盖不了某区某校的真实差异。这就引出 Harness 该补上的那一半。
四、把两者打通:基座做“插件内核”,上层“开箱 + 自组装”
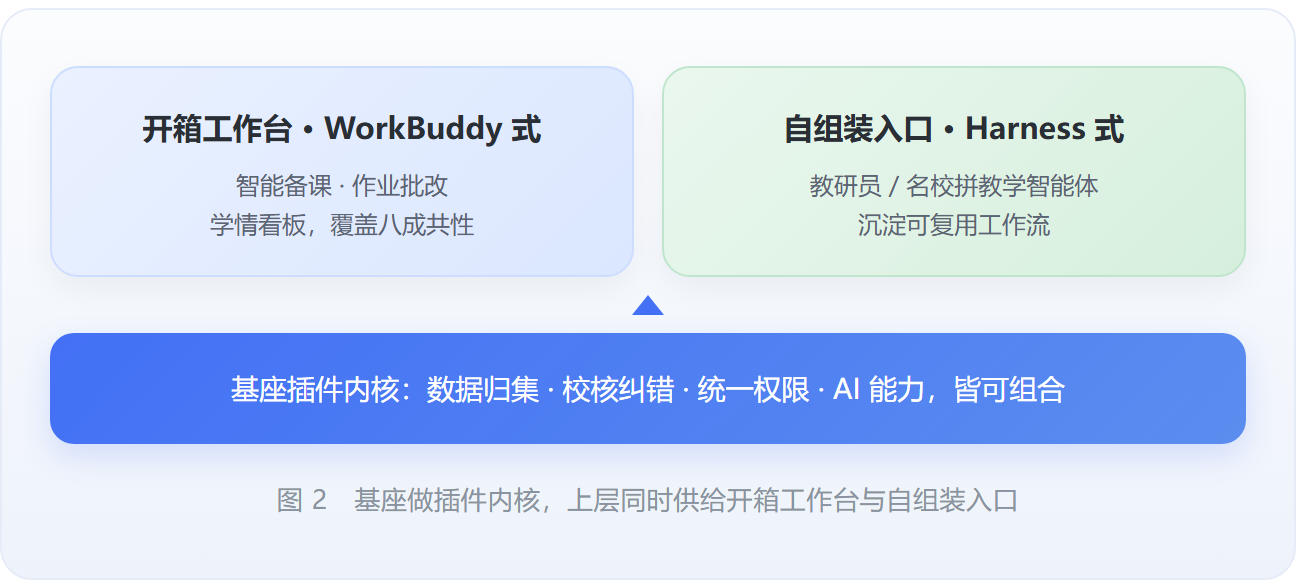
结合点在这里。基座向下收敛成一个插件化内核,所有能力皆可组合;上层应用分两类:一类是 WorkBuddy 式开箱工作台,覆盖八成共性场景,老师拿来就用;一类是 Harness 式自组装入口,留给教研员和名校,去拼自己的“教学智能体”,把经验沉淀成可复用工作流。
这样基座既不像纯开箱那样不够用,也不像纯积木那样门槛高。一个区里,多数学校吃开箱套餐;那所教研强的名校,自己用创造入口长出一套分层作业智能体,再开放给全区加载。同一个基座,两种活法。
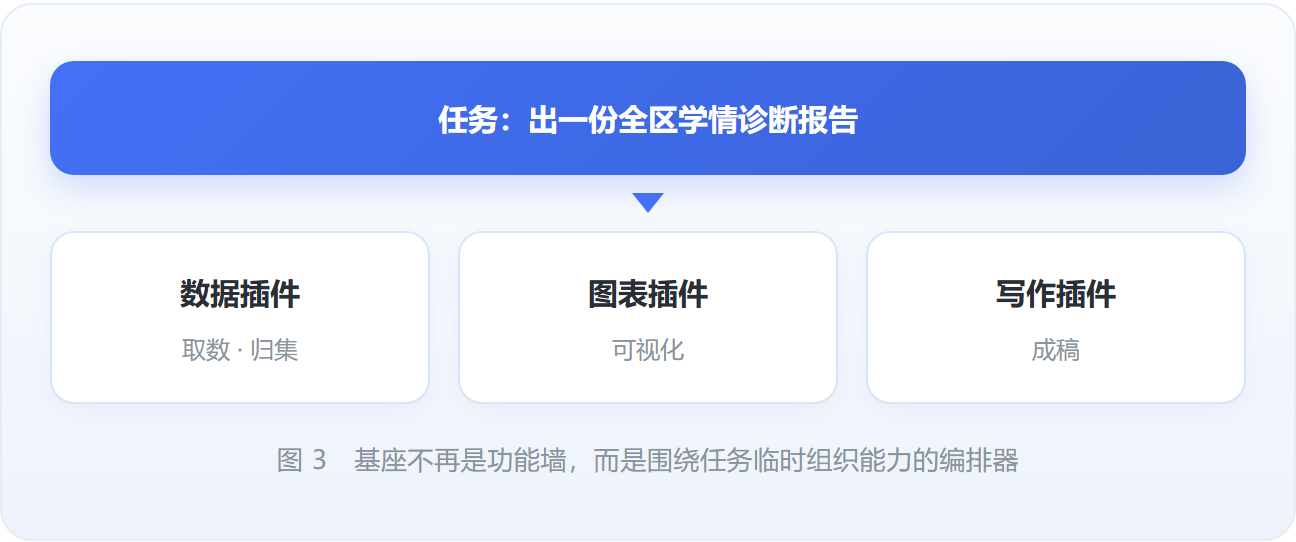
更深一层,是从“以功能为中心”转向“以任务为中心”。老师此刻的真实任务是“备一节分数的初步认识”,不是“打开备课系统五个菜单”。如果基座能围绕这个任务,临时把数据插件、图表插件、写作插件编排起来,老师只说一句话,东西就出来了。这就是 Harness 的任务编排,也是我们产品该补的课。
五、和智能体编辑平台不是一回事:路和车,不是对手
顺带把另一个容易混的概念说清。智能体编辑平台,就是那种低代码拼 agent 的工具,拖提示词、挂工具、接知识、排工作流。不少人一听“基座也做插件、也做编排”,就觉得我们要去造一个智能体编辑平台。不是。
区别在层次。智能体编辑平台解决的是“怎么把 agent 造出来”:可视化编排、提示词调试、工具挂载、知识库接入。它面向的是造车的工位。基座解决的是“agent 造出来之后,能不能跑得起来、跑得对”:数据归集与校核决定它喂得进真数据还是脏数据;统一权限决定谁能看哪个年级哪个班;分级分类决定把东西推给谁。它面向的是路、油站和交规。
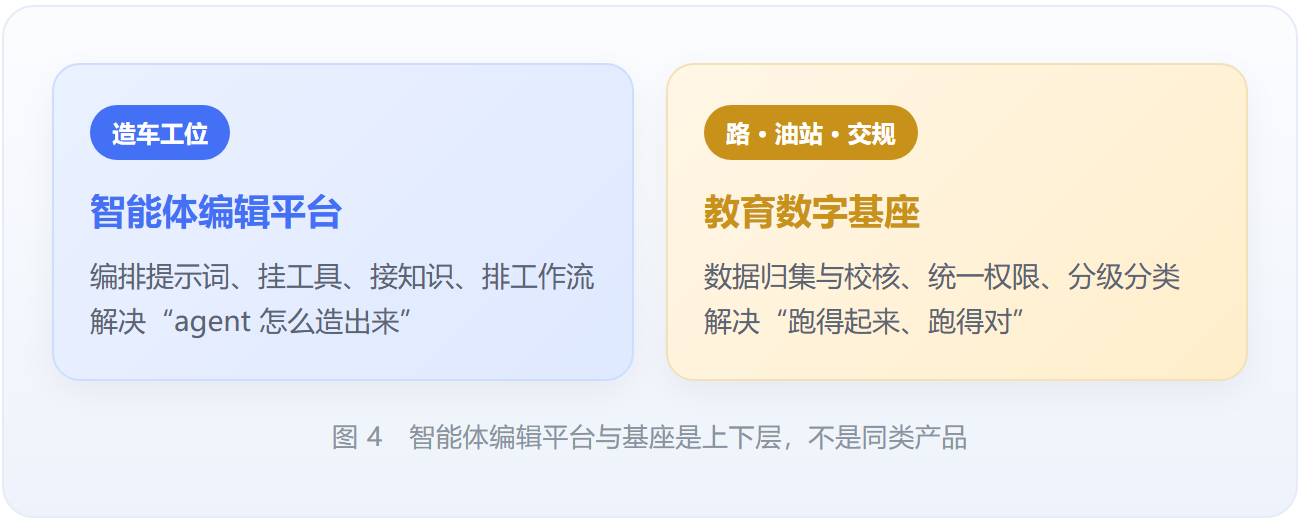
一个很具体的反差。在通用编辑平台里拖一个“学情查询”组件,连的是裸接口,数据对不对、权限管不管得住,平台不管。在带基座的体系里,这个组件背后是基座的校核与统一权限:校长看到的和班主任看到的天然不同,且数据经过校核。同一个“学情查询”,治理深度完全两样。
所以两者不是对手,是上下层。基座把底层能力做成“带治理的插件”,供给上方任意编辑平台调用。编辑平台上用户拼得再花,每一块都带着基座的权限、校核、数据。反过来讲,没有基座,编辑平台造出的 agent 是空壳;没有编辑平台,基座的能力只能靠厂商预置,长不出一线自己的智能体。
我们的定位因此不是再去做一个通用智能体编辑平台,而是把基座做成“可被任意编辑平台调用的插件内核”:既接 WorkBuddy 式开箱,也接 Harness 式自组装。这一点,正好和前面说的“生长权交出去”接上了。
六、PTC 与创造模式:让基座长出“处方性”和“自生长”
Harness 四种模式里,PTC(Programmatic Tool Calling)值得基座借鉴。模型先生成代码,再组织多轮工具调用。落到教育里,这就是“处方性分析”的关键:不只告诉校长“这个班平均分 75”,而是预测“哪类题是主要失分点”,再开处方“下一步推哪一道、给哪组学生”。PTC 让模型从诊断一路编排到推送落地。
创造模式更关键。它能检查运行时、在内存里试插件、组合出新模式。翻译成基教平台:给教研员和名校一个“创造”入口,让他们把教学判断沉淀成可运行工作流,而不是永远等我们排期。WorkBuddy 擅长把成熟流程做成可复用工作台;Harness 创造模式擅长让一线去生长新流程。基座要同时接得住这两种,才叫真开放。
七、真正值钱的不是模型,是知识库
一个很能说明问题的对照:先用空泛提示词让模型备课,质量一般;再喂进一批“学习路径”理论文献后备同一节,教案立刻从通用模板变成有教学思想的设计。结论直白:AI 不会自动拥有教学思想,它只放大你给的思想。
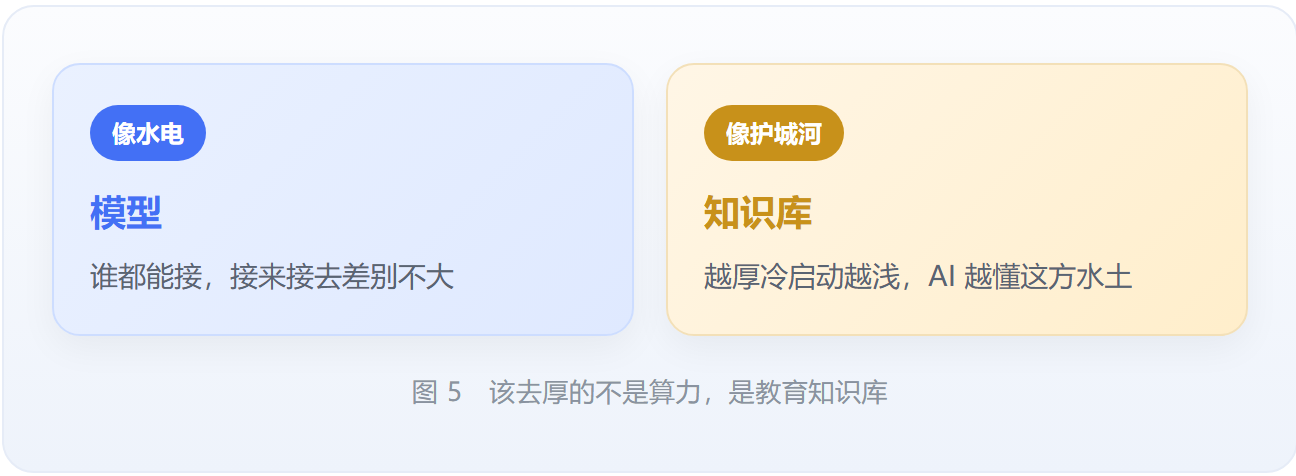
这话该贴每个产品决策会。大模型终成水电,谁都能接。护城河是知识库:区域教研沉淀、课标教材图谱、学校端真实学情、家长端反馈、名师课堂经验。越厚,冷启动越浅,AI 越像“懂这方水土的老师”。这也解释“先建数据基座、再上 AI 应用”为什么对:没有基座的数据归集和校核,AI 应用就是空壳,推的题都可能建在脏数据上。
八、边界与飞轮:把掌舵权留在人手里
行业里现在常聊一个词,叫“加速主义焦虑”:AI 把做课件从五小时压到五分钟,可那五小时没消失,只是换成改提示词的形式。真正问题不是 AI 快不快,是我们有没有判断、修改、驾驭它的方法。产品不能只追“一键生成”,要在流程里嵌审核、解释、可追溯。
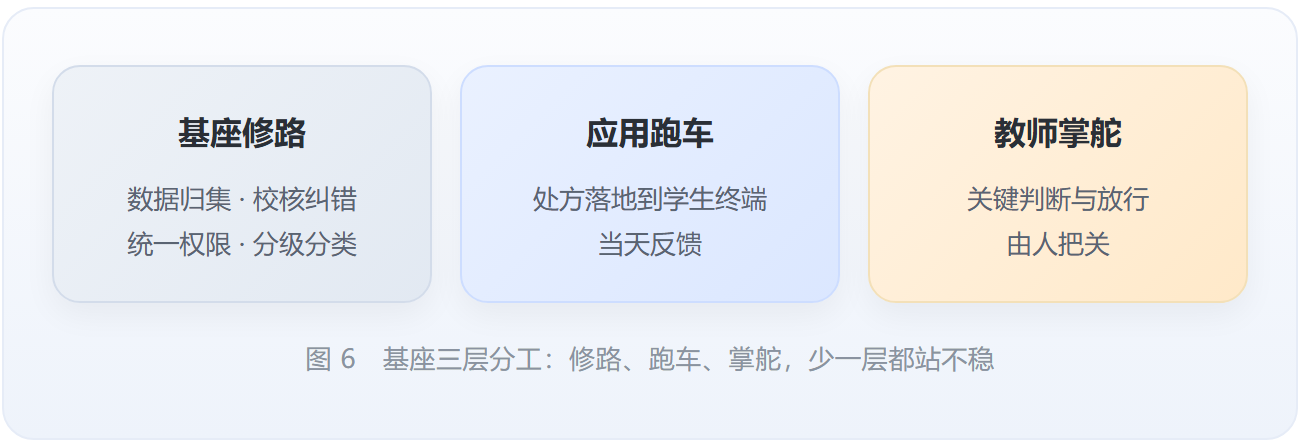
所以基座的分层我一直这么看:基座修路,负责数据归集、校核纠错、统一权限、分级分类,把地面铺平;应用跑车,负责把处方落地到学生终端,当天就有反馈;教师掌舵,关键的那一下判断和放行由人来做。大模型能讲解能出题,但“裁判”不能交给它,幻觉风险是真实的。我在一个项目里见过,模型把“平均分”讲得头头是道,细看却在拿分子分母当孤立数字用,正是学生最容易掉的坑。
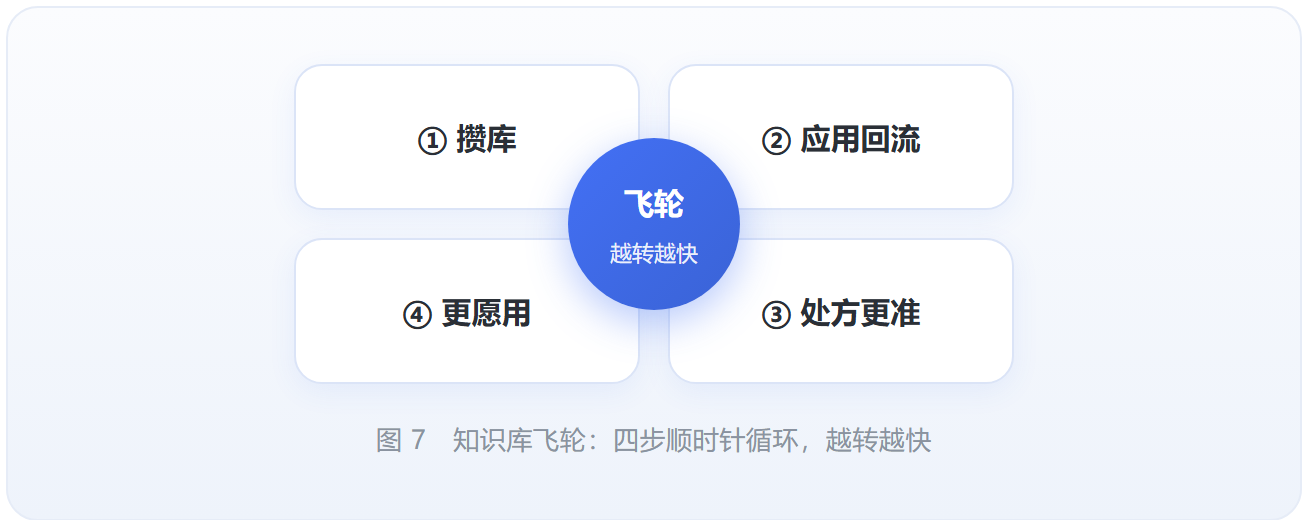
落到飞轮。我见过一个很巧的做法:用创造模式搭个每日论文推送,会在 criteria.md 里记“哪些该推、哪些不该推”,按反馈自进化。学情画像的终点,我坚持是“下一步推哪一道”,不是“学生长什么样”。每推一次,学生做没做对、教师改没改,信号都要回流。回流越多处方越准,越准越愿用,越用库越厚。这是飞轮不是流水线。
写到这里,三样东西的关系我算想顺了。
基座是 Harness 的实体,把连接与组织这件事做成可运行的底座;WorkBuddy 是它最成熟的一种开箱形态,负责把共性流程直接供给老师;Harness 真正教我们的,是把“生长权”交出去,让教研员和名校能自己拼出专属智能体,而不必永远等厂商排期。智能体编辑平台和基座也不是对手,前者造车、后者修路供油定交规,基座把能力做成带治理的插件,谁都能来调用。我们的活,不是再做一个更花哨的工作台,而是把基座这副马具做得足够标准、又足够能拆能拼。
下一步,我打算先把基座里耦合最死的那几个功能拆成插件试点。
马具标准了,马车自然有人造。
评论 (0)
发表评论